
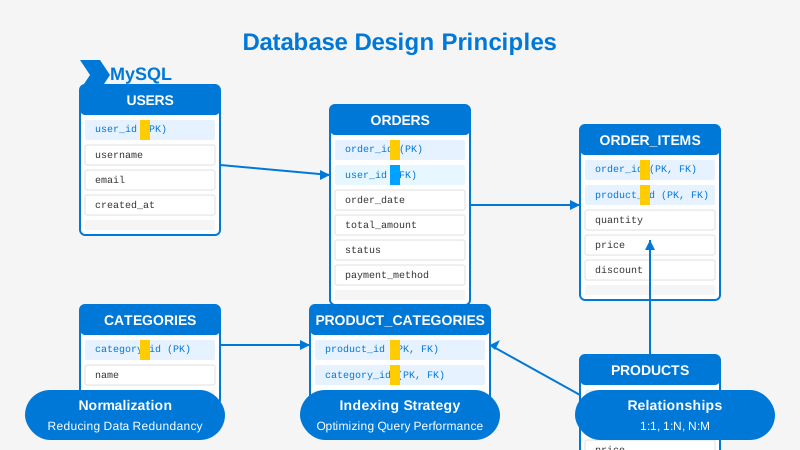
Versione di riferimento: MySQL 8.4 con InnoDB. Un database sostenibile nasce da vincoli espliciti e da dati che hanno un solo significato. La normalizzazione aiuta a evitare aggiornamenti incoerenti; le prestazioni si valutano poi sulle letture e sulle scritture reali.
Partire da valori atomici e chiavi stabili
La prima forma normale non richiede semplicemente “più tabelle”: richiede che ogni colonna contenga un valore atomico e che non esistano gruppi ripetuti come product1, product2 e così via. Un ordine e le sue righe sono due concetti diversi:
CREATE TABLE customers (
  id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,
  email VARCHAR(255) NOT NULL,
  name VARCHAR(150) NOT NULL,
  PRIMARY KEY (id),
  UNIQUE KEY uq_customers_email (email)
) ENGINE=InnoDB;

CREATE TABLE orders (
  id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,
  customer_id BIGINT UNSIGNED NOT NULL,
  placed_at DATETIME NOT NULL,
  PRIMARY KEY (id),
  KEY idx_orders_customer_placed (customer_id, placed_at),
  CONSTRAINT fk_orders_customer
    FOREIGN KEY (customer_id) REFERENCES customers(id)
) ENGINE=InnoDB;

CREATE TABLE order_items (
  order_id BIGINT UNSIGNED NOT NULL,
  line_no SMALLINT UNSIGNED NOT NULL,
  sku VARCHAR(64) NOT NULL,
  quantity INT UNSIGNED NOT NULL,
  PRIMARY KEY (order_id, line_no),
  CONSTRAINT fk_items_order
    FOREIGN KEY (order_id) REFERENCES orders(id)
) ENGINE=InnoDB;
Il vincolo UNIQUE esprime che una e-mail non può identificare due clienti; la chiave esterna impedisce righe orfane. Queste regole proteggono il dato anche quando l’applicazione cambia o quando uno script accede direttamente al database.
Normalizzare fino a dove serve
La seconda e la terza forma normale aiutano a separare gli attributi che dipendono da entità diverse. Per esempio, il nome del cliente non va copiato in ogni ordine: una correzione dovrebbe avvenire in un solo punto. La normalizzazione riduce ridondanza e anomalie di aggiornamento, ma non sostituisce una scelta consapevole di tipi, indici e query.
La denormalizzazione è una scelta mirata, non il passo successivo obbligato. Può essere ragionevole per una tabella di riepilogo o un valore calcolato molto letto, dopo avere dimostrato il collo di bottiglia e definito come mantenere coerente la copia. Prima di duplicare dati, misura la query, leggi il piano e valuta il costo di aggiornare ogni duplicato.
Indici e relazioni seguono gli accessi
L’indice (customer_id, placed_at) serve, ad esempio, alle richieste degli ordini di un cliente in un intervallo o in ordine temporale. Non rende veloci automaticamente tutte le query su placed_at: gli indici composti dipendono dall’ordine delle colonne e gli indici in più aumentano il costo delle scritture.
Per verificare l’uso effettivo, esegui EXPLAIN sulla query più importante e confronta la scelta dell’ottimizzatore con dati rappresentativi. L’articolo collegato su ottimizzazione delle query MySQL mostra come leggere il piano senza trasformarlo in una regola assoluta.
Checklist prima della migrazione
- Definisci chiavi primarie, unicità e relazioni che il dominio richiede.
- Usa tipi coerenti sulle colonne di join e prevede i casi
NULL. - Prova inserimenti validi e violazioni previste in un ambiente isolato.
- Misura le query reali prima di aggiungere indici o copie denormalizzate.
Il manuale MySQL 8.4 sulla struttura dei dati raccomanda in generale dati non ridondanti e ammette duplicazioni o tabelle di riepilogo quando il beneficio di lettura giustifica il costo di manutenzione.